Waar haalt AI zijn beeld van je merk vandaan?
Trainingsdata of live opgehaalde pagina's? Zo herken je welke bronnen bepalen hoe AI je merk beschrijft, en welke sites ChatGPT volgens een datarapport citeert.
Waarom noemt Perplexity je "vooral geschikt voor kleine teams" terwijl je de laatste twee jaar alleen maar grotere klanten hebt binnengehaald? Wie die vraag stelt, zoekt eigenlijk naar een bron. Een taalmodel heeft geen mening over je bedrijf. Het herhaalt, combineert en vat samen wat het ergens gelezen heeft. Als je weet waar, weet je ook waar je iets kunt veranderen.
Dit artikel gaat over die bronnen: de twee routes waarlangs AI informatie over je merk binnenkrijgt, de soorten bronnen die je in een antwoord tegenkomt, en wat een datarapport over ChatGPT-citaties zegt over welke sites er echt toe doen.
Twee routes: geheugen en live zoeken
De eerste route is trainingsdata. Een model is getraind op een grote hoeveelheid tekst van het web, en wat het daaruit over je merk heeft opgepikt, zit in zijn "geheugen". Vraag je zo'n model iets zonder dat het gaat zoeken, dan antwoordt het daaruit. Dat beeld kan verouderd zijn, en je kunt het niet direct bijwerken. Het verandert pas als het model opnieuw getraind wordt.
De tweede route is live zoeken. ChatGPT Search, Perplexity, Google AI Overviews en Google AI Mode zoeken op het moment van de vraag, halen pagina's op en baseren hun antwoord daarop. Wat vandaag op je prijspagina staat, kan vandaag in een antwoord terechtkomen. Ook wat vandaag op de site van een concurrent of een vergelijkingsblog staat.
Promptwatch maakt dat onderscheid zichtbaar in hoe het modellen volgt. Live zoekende platforms worden verzameld uit het echte product: geautomatiseerde sessies in de ChatGPT-interface, echte Google-resultatenpagina's voor AI Overviews en AI Mode. Modellen zoals DeepSeek en Mistral worden bewust via hun API gevolgd, omdat ze laten zien wat het model zelf over je merk gelooft, los van de zoekresultaten van vandaag. Claude draait volgens de Academy via de API met een zoektool erbij.
Voor perceptie heeft dat een praktisch gevolg. Een verouderde claim die je op je site hebt gecorrigeerd, kan uit de live antwoorden verdwijnen en in een API-model blijven hangen. Dat is geen teken dat je correctie mislukt is.
Wat er in een antwoord zit
Citaties bestaan alleen als een model echt gezocht heeft. Een antwoord zonder citaties is normaal voor een model dat uit trainingsdata antwoordt. Bij live zoekende engines zie je bronnen terug als genummerde verwijzingen in de tekst of als bronkaartjes met een URL en titel.
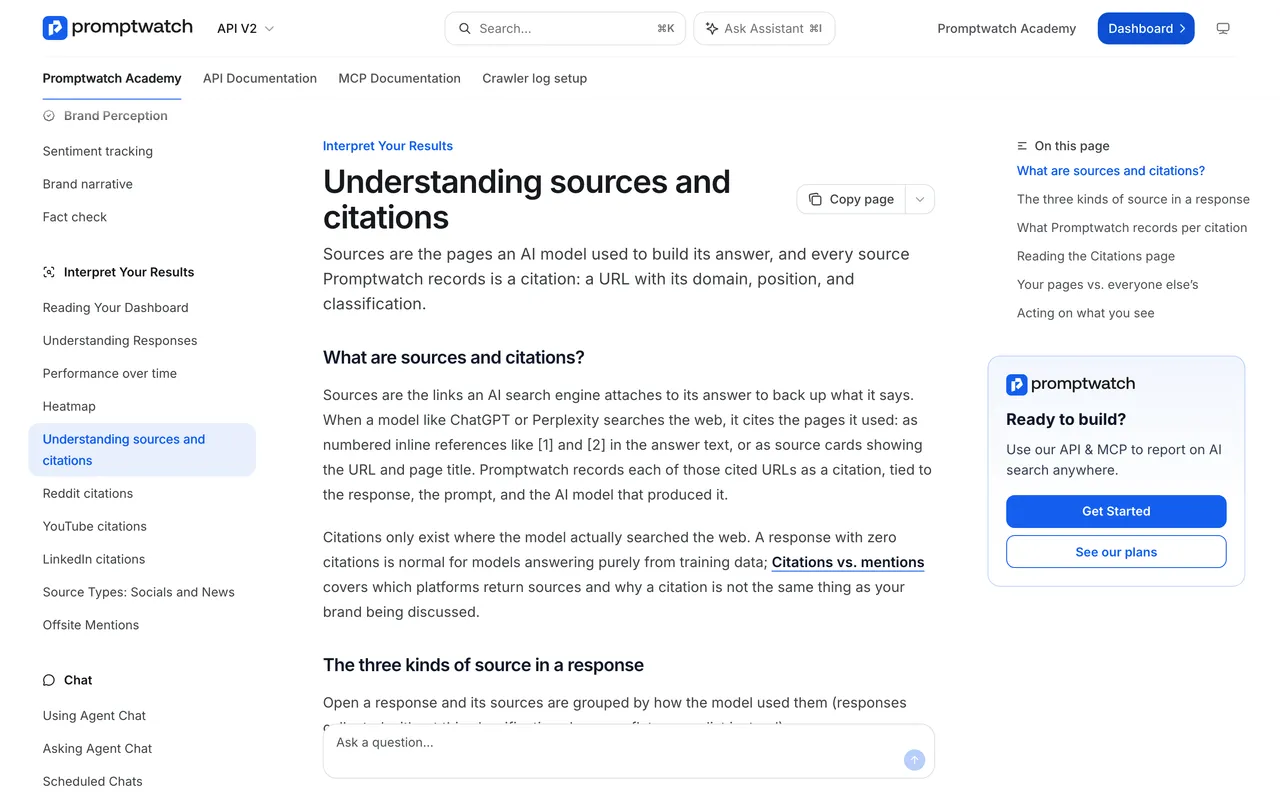 De pagina Understanding sources and citations in de Promptwatch Academy, vastgelegd op 14 november 2026.
De Promptwatch Academy onderscheidt drie soorten bronnen in een antwoord, en dat onderscheid is nuttig als je wilt weten wat je beeld bepaalt:
- Inline citaties: bronnen die direct in de tekst worden aangehaald. Die wegen het zwaarst, omdat ze een specifieke bewering onderbouwen.
- Voetnoten: bronnen in de lijst onder het antwoord, wel geciteerd maar niet aan een bepaalde zin gekoppeld.
- Zoekresultaten: pagina's die het model bekeek tijdens het zoeken, maar niet citeerde.
Staat een vergelijkingsartikel inline bij de zin "geschikt voor kleine teams", dan heb je je bron waarschijnlijk gevonden. Staat je eigen productpagina alleen bij de zoekresultaten, dan heeft het model hem wel gezien maar er niet op gebouwd.
Per citatie legt Promptwatch de URL en het domein vast, de positie in de bronnenlijst, het brontype (van nieuwssites tot Reddit-draadjes), het contenttype (zoals een lijstje, review of vergelijking) en de domain rank, een maat voor hoe gezaghebbend het domein is.
Welke sites ChatGPT citeert: het datarapport over domain rank
De vraag welke sites je beeld bepalen, heeft een verrassend antwoord als je naar de cijfers kijkt. Promptwatch publiceerde een rapport over het aandeel ChatGPT-citaties per domain rank in augustus 2026.
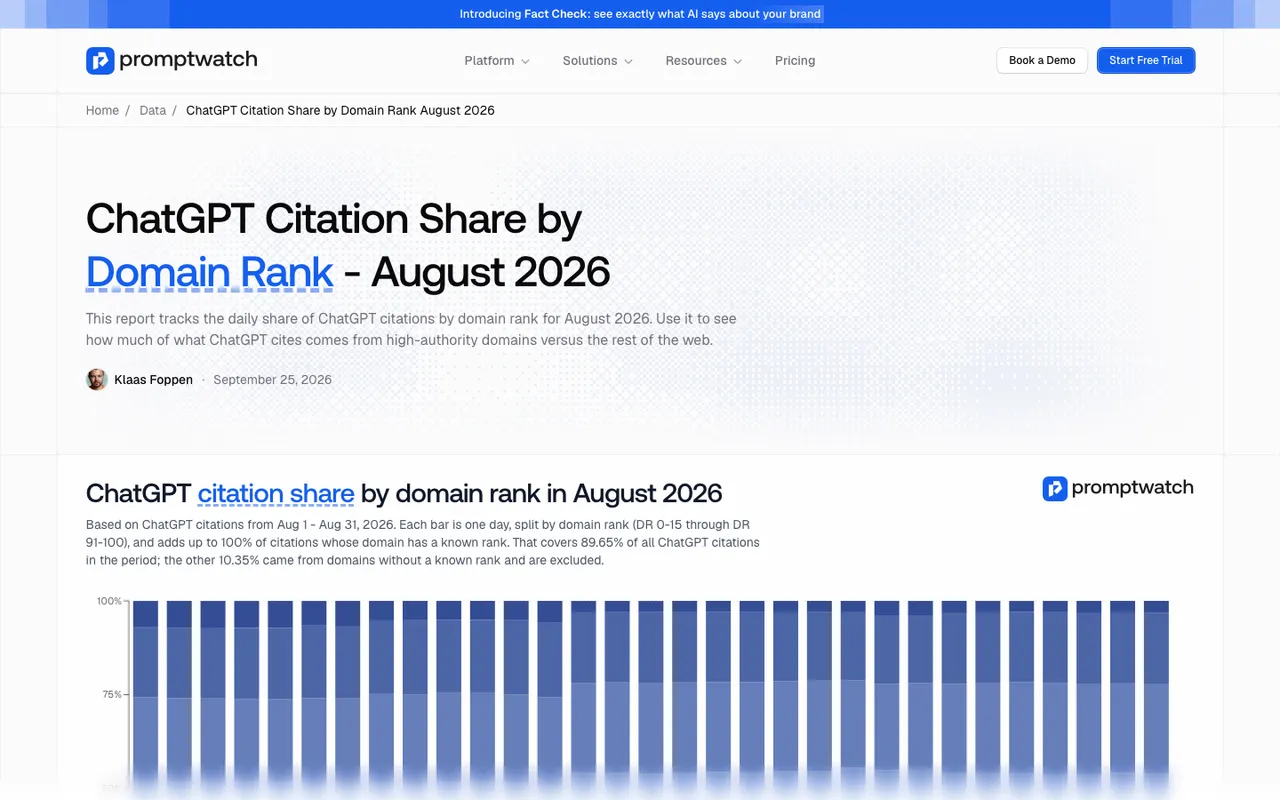 Het datarapport over ChatGPT-citaties per domain rank in augustus 2026, vastgelegd op 14 november 2026.
Volgens dat rapport citeert ChatGPT vooral middelgrote en vrij sterke sites, niet de grootste websites van het internet. Domeinen met een rank van 46 tot 60 kregen 22,6% van de citaties en domeinen van 61 tot 75 kregen 23,4%, samen bijna de helft. De groep 76 tot 90 kwam op 18,9%. De top, domain rank 91 tot 100, zakte in de loop van augustus van ongeveer 7% in de eerste week naar ongeveer 3%, en kwam over de hele maand gemiddeld uit op 4,4%. Sites met een rank van 0 tot 45 kregen samen nog bijna een derde van alle citaties.
Het rapport merkt op dat de tweede daling van de topgroep op dezelfde dag viel als de ineenstorting van het aandeel Reddit in ChatGPT-citaties. De cijfers gaan over citaties van domeinen met een bekende rank, en dat was 89,65% van alle ChatGPT-citaties in die maand.
Wat betekent dat voor je merkimago? Dat het niet alleen bepaald wordt door een artikel in een groot landelijk medium. Het wordt minstens zo sterk gevormd door vakblogs, vergelijkingssites, brancheportalen en reviewplatforms van gemiddelde omvang. Dat zijn sites waar je als merk vaak gewoon iemand kunt mailen, en waar een verouderde beschrijving van je product lang kan blijven staan als niemand hem bijwerkt.
Eén kanttekening: dit rapport gaat over ChatGPT in één maand. Andere engines citeren anders, en verschuivingen zoals die van de topgroep laten zien dat het patroon kan veranderen.
Je bronnen in kaart brengen
Om te weten welke pagina's jouw beeld bepalen, heb je de citaties nodig van de prompts die jij volgt. De pagina Citations in Promptwatch heeft drie tabbladen.
All Citations toont de meest geciteerde domeinen in de tijd en een lijst met het aandeel van elk domein. Je eigen domein staat er altijd tussen, ook als het nul citaties heeft. Dat aandeel is je self-citation rate. Daaronder staat elke geciteerde URL met brontype, contenttype, modellen, aantal citaties, gemiddelde positie en domain rank.
URL Positions laat zien waar de meest geciteerde URL's in de bronnenlijsten landen, ook die van concurrenten.
Citation Trends kijkt naar de levensloop van een pagina over de afgelopen 90 dagen: wanneer hij voor het eerst geciteerd werd, hoe lang het duurde tot de piek, en hoe snel het citatieaandeel daarna halveerde. Daar zie je dat citaties verdiend en verloren worden, niet voor altijd vastliggen.
Koppel dat aan perceptie via Brand Narrative. Elke claim heeft een tabblad Citations met de pagina's die naast die claim geciteerd werden. Een geciteerde pagina is niet per se de bron van de claim, waarschuwt de Academy, maar het is de eerste plek om te kijken. Op Business, Agency Scale en Enterprise gaat Fact Check verder: dat leest je eigen site en tot 50 van de meest geciteerde pagina's en laat zien welke de claim stellen of tegenspreken.
Wat je met een bron kunt doen
Hangt de bron aan je eigen site, dan pas je die pagina aan. Dat heb je het meest in de hand, en live zoekende engines kunnen de nieuwe versie ophalen zodra hij online staat.
Is de bron een site van derden, dan wordt het pr- en relatiewerk. Vraag een correctie, lever actuele informatie aan, zorg dat je profiel op een reviewplatform klopt. Promptwatch heeft daarvoor ook offsite mentions: pagina's van anderen die je merk noemen zonder link, gerangschikt als kansen. Gezien het datarapport loont het om juist naar de middelgrote sites in die lijst te kijken.
Is er geen bron, en vult het model een gat, dan is de oplossing een pagina die het ontbrekende feit in gewone woorden zegt. Een model kan alleen citeren wat ergens staat.
En komt het uit trainingsdata, dan heb je geduld nodig. Verbeter de pagina's toch, want de volgende versie van het model leert van wat er dan staat.
Begin bij je eigen citaties
Wil je zien welke pagina's nu je beeld in ChatGPT, Perplexity en Google AI Overviews bepalen, start dan de proefperiode van 7 dagen via de prijspagina van Promptwatch. Voeg je belangrijkste koopvragen toe en open na een paar dagen All Citations. De eerste tien domeinen in die lijst zijn je eerste werklijst. Meer over het verschil tussen geciteerd worden en genoemd worden staat in Citaties versus vermeldingen in AI-antwoorden.