Merkperceptie in AI: wat het is en hoe je het meet
Merkperceptie in AI is hoe ChatGPT, Gemini en andere engines je merk beschrijven, niet alleen of ze je noemen. Zo splits je dat beeld op en meet je het.
Vraag een AI-assistent welke planningssoftware past bij een installatiebedrijf met tien monteurs, en je krijgt geen lijst met blauwe links. Je krijgt een oordeel. Het ene pakket is "betaalbaar voor kleine teams", het tweede "krachtig maar lastig in te richten", het derde "vooral bedoeld voor grotere organisaties". Die korte typeringen samen vormen wat we merkperceptie in AI noemen: het beeld dat een taalmodel van je merk neerzet als iemand ernaar vraagt.
Dat beeld is iets anders dan zichtbaarheid. Zichtbaarheid gaat over de vraag of je genoemd wordt. Perceptie gaat over hoe. Je kunt in bijna elk antwoord staan en toch steeds het etiket "duur" of "verouderd" meekrijgen. Andersom kan een merk zelden opduiken, maar dan wel met precies de woorden die het zelf zou kiezen. Wie alleen telt hoe vaak de naam valt, ziet dat verschil niet.
Waar merkperceptie uit bestaat
Leg twintig AI-antwoorden over je merk naast elkaar en je ziet steeds dezelfde bouwstenen.
De eerste laag zijn eigenschappen. Snel, betaalbaar, gebruiksvriendelijk, beperkt. Dat zijn de bijvoeglijke naamwoorden die een model aan je naam hangt, en ze zijn grotendeels een kwestie van smaak. Daaronder liggen concrete claims, zoals "heeft een koppeling met Exact Online" of "biedt geen support in het weekend". Een claim is waar of onwaar, en dat maakt hem anders dan een eigenschap.
Vergelijkingen zijn een eigen categorie. Bij een vraag als "Acme of Globex, wat past beter bij een storingsdienst?" bepaalt het model wie de standaardkeuze is en wie het alternatief. (Acme en Globex zijn hier verzonnen namen.) Dan is er de framing: voor wie ben je volgens AI bedoeld? "Vooral geschikt voor zzp'ers" sluit een bedrijf met twintig man personeel stilletjes uit, zonder dat er iets negatiefs gezegd wordt. De laatste laag is toon: klinkt het antwoord als geheel positief, neutraal of kritisch?
Die lagen bewegen niet altijd samen. Een antwoord kan je warm aanbevelen en in dezelfde alinea een verkeerde prijs noemen. Daarom is één cijfer voor "hoe AI over ons denkt" te grof om op te sturen.
Zichtbaarheid, sentiment en perceptie zijn verschillende metingen
Het helpt om de begrippen strak uit elkaar te houden. We gebruiken de definities van Promptwatch, omdat die openbaar en precies beschreven zijn.
De Visibility Score loopt van 0 tot 100 en zegt hoe prominent je merk verschijnt in de antwoorden op de prompts die je volgt. Elk antwoord wordt gescoord op plaatsing, aandeel van de aandacht en diepgang, en antwoorden waarin je niet voorkomt tellen als nul. Het is een maat voor aanwezigheid, niet voor wat er gezegd wordt.
De sentimentscore meet de toon op een schaal van 100 punten. Rond 50 is neutraal, hoger is gunstiger. De Promptwatch Academy is daar expliciet over: sentiment staat los van zichtbaarheid. Een antwoord dat volledig draait om de problemen met je product kan hoog scoren op zichtbaarheid en laag op sentiment, en juist die combinatie wil je opvangen. Kale vermeldingen, waarin je naam alleen in een rijtje staat zonder enig oordeel, krijgen geen sentimentscore. Er wordt dus geen nep-neutraal gemiddelde opgebouwd uit lege vermeldingen.
Perceptie op claimniveau gaat nog een stap verder. Brand Narrative, een pagina in Promptwatch onder Brand perception, haalt de afzonderlijke beweringen over jou en je concurrenten uit de antwoorden, groepeert ze per thema en scoort ze. De Academy geeft een goed voorbeeld van waarom dat nodig is: een sentimentscore van 62 vertelt je de toon, de claims erachter vertellen je dat AI je support prijst en aan je mobiele app twijfelt.
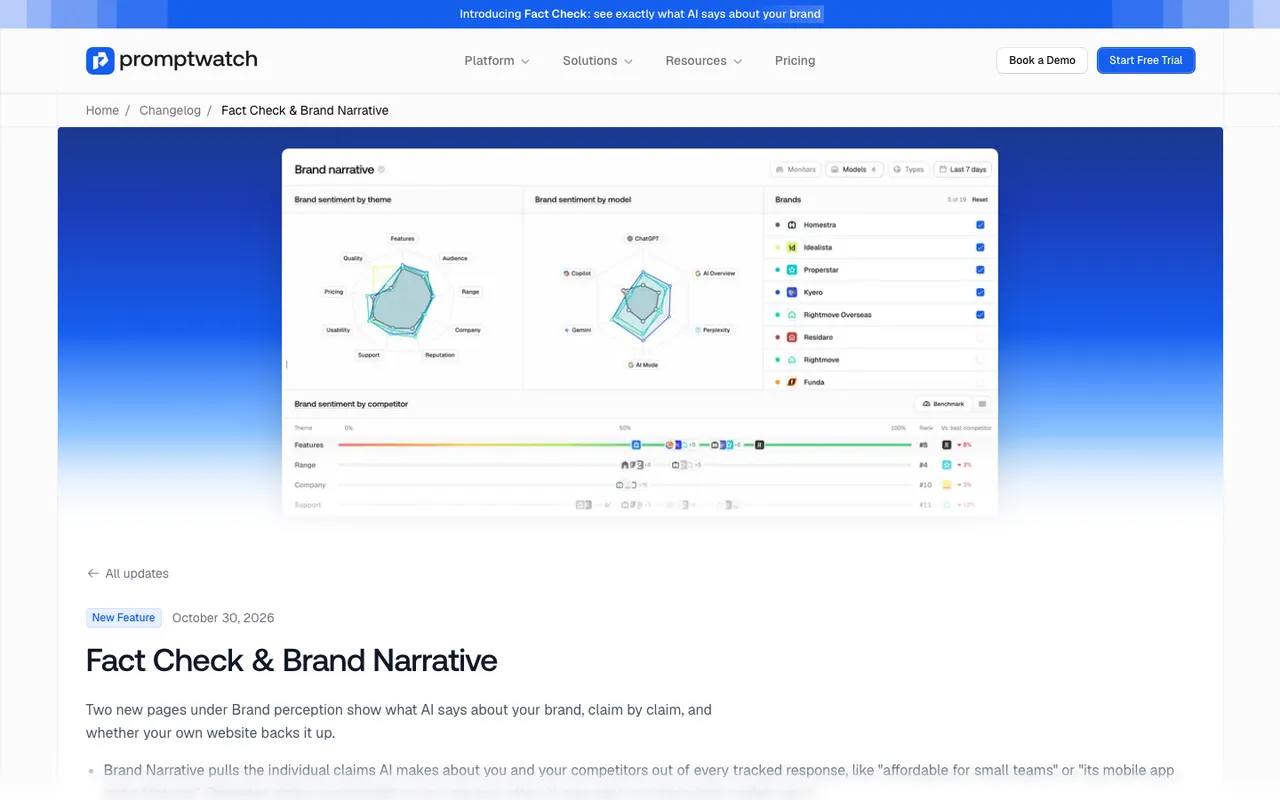 De changelogaankondiging van Fact Check en Brand Narrative (30 oktober 2026), vastgelegd op 14 november 2026. De productweergave is een illustratie met voorbeeldmerken.
Hoe AI aan zijn beeld van je merk komt
Een model verzint zijn oordeel niet uit het niets. Het beeld komt grofweg langs twee wegen binnen. Engines die live zoeken, zoals ChatGPT Search, Perplexity en Google AI Overviews, halen pagina's op en citeren ze. Wat op je prijspagina staat, in een vergelijkingsartikel of in een reviewoverzicht, kan dezelfde dag in een antwoord terechtkomen. Modellen die antwoorden uit hun trainingsdata, zoals DeepSeek en Mistral, laten zien wat het model zelf al over je "weet", los van de zoekresultaten van vandaag. Promptwatch volgt die tweede groep bewust via de API, omdat dat precies is wat ze representeren.
Het gevolg is dat je merk per model anders beschreven kan worden. Een verouderde claim kan in een API-model blijven hangen terwijl ChatGPT al de nieuwe versie van je site citeert. Waar die bronnen vandaan komen, werken we uit in Waar haalt AI zijn beeld van je merk vandaan?.
Wat je concreet kunt meten
Brand Narrative maakt perceptie meetbaar zonder dat je honderden antwoorden met de hand hoeft door te lezen. Een paar spelregels houden de lijst schoon. Een claim blijft alleen staan als het citaat letterlijk in het antwoord voorkomt en minstens vier woorden lang is. De claim moet over een merk gaan dat je volgt. Herhalingen in andere bewoordingen worden gegroepeerd, zodat je ziet hoe vaak AI iets zegt en welke modellen het zeggen. En claims die een prijs noemen worden weggelaten, omdat prijzen te vaak veranderen om een bruikbaar verhaal te vormen.
Elke claim valt onder een van negen thema's: Pricing, Features, Quality, Usability, Range, Support, Reputation, Audience en Company. Dat laatste gaat over feiten over het bedrijf zelf, zoals eigendom en waar je actief bent. Audience is het thema voor de framing die we hierboven beschreven: voor wie je bedoeld bent.
Elk citaat krijgt een score van 0 tot 100. Onder de 40 telt als negatief, 60 en hoger als positief, alles daartussen als neutraal. Een themascore is het gemiddelde van alle citaten binnen dat thema, dus claims die AI vaak herhaalt wegen zwaarder dan een uitschieter. Een thema op 80 is vooral lof, een thema op 30 vooral kritiek.
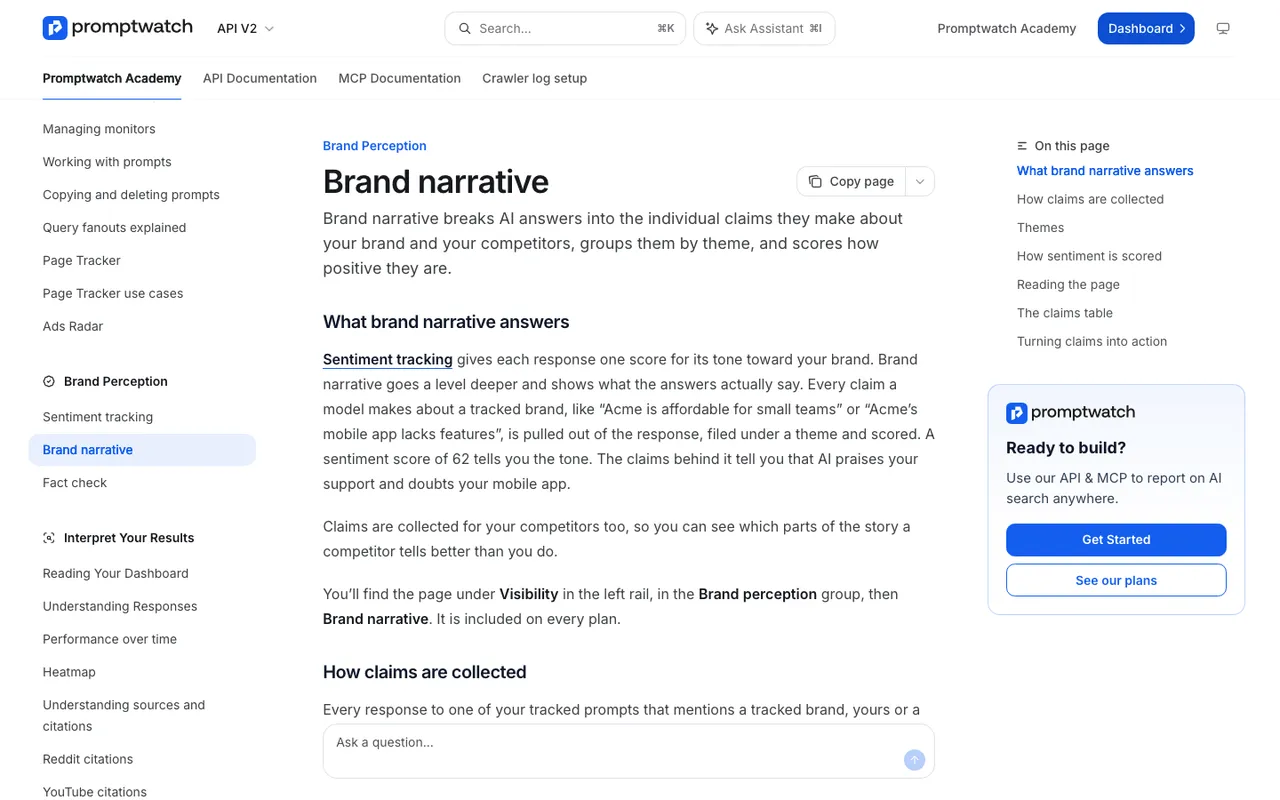 De pagina Brand narrative in de Promptwatch Academy, vastgelegd op 14 november 2026.
Het nuttigste onderdeel voor een marketingteam is de benchmark. Per thema zie je waar je staat ten opzichte van elke concurrent, je rang, en het verschil met de best scorende concurrent. Daaronder staat een tabel met claims, de meest negatieve bovenaan. Klik je een claim open, dan zie je de citaten, de antwoorden, de prompts en de pagina's die in die antwoorden geciteerd werden.
Wil je ook weten of een claim klopt, dan is er Fact Check. Dat legt een claim naast je eigen site en de meest geciteerde pagina's en zegt of die de claim bevestigen of tegenspreken. Fact Check zit op Business (579 $/maand), Agency Scale en Enterprise. Brand Narrative zelf zit op elk plan.
Een meetopzet die iets zegt
De kwaliteit van je perceptiemeting hangt af van de prompts die je volgt. Neem weer het verzonnen Acme, planningssoftware voor installateurs. Een bruikbare set mengt drie soorten vragen:
- Organisch, zonder merknaam: "Welke planningssoftware is geschikt voor een installatiebedrijf met tien monteurs?"
- Merkspecifiek: "Is Acme geschikt voor kleine bedrijven?" of "Wat zijn de nadelen van Acme?"
- Vergelijkend: "Acme of Globex, wat werkt beter voor een storingsdienst?"
Die mix is geen formaliteit. De Academy merkt op dat vergelijkingsprompts meestal lager scoren op sentiment dan informatieve vragen, omdat het antwoord je afweegt tegen anderen. Tel je alles op één hoop, dan lijkt een daling soms een perceptieprobleem terwijl je alleen meer vergelijkingsprompts bent gaan volgen. Filter daarom per prompttype.
Prijsvragen horen er ook bij, maar lees die anders. Omdat Brand Narrative claims met een bedrag weglaat, zie je een verkeerde prijs daar niet terug. Die vind je in de antwoorden zelf. Wat Brand Narrative wel laat zien, is de perceptie van je prijs: of AI je "duur", "goede waarde" of "geschikt voor een klein budget" noemt.
Kijk verder naar periodes, niet naar losse dagen. Op een dag met weinig vermeldingen kan één hard antwoord het daggemiddelde flink laten zakken. Een daling over meerdere dagen is een signaal, een dip van één dag meestal ruis.
Wat een meting niet kan
Een perceptiemeting vertelt je wat AI zegt. Ze bewijst niet wat waar is. De Academy zegt dat over Fact Check met zoveel woorden: een check rapporteert wat pagina's zeggen, niet wat klopt. Of je een gratis versie hebt, weet jij beter dan welke pagina ook.
Ook kun je niet alles sturen. Een concurrent die een sterke lancering heeft, kan je relatieve positie in vergelijkende antwoorden verslechteren zonder dat er aan jouw kant iets is veranderd. Een echte zwakte in je product blijft terugkomen tot je hem oplost, en soms nog een tijd daarna. En een aangepaste pagina garandeert niet dat een model morgen anders antwoordt. Je kunt de bronnen verbeteren en daarna meten of een claim zeldzamer wordt.
Zo begin je
Kies tien tot twintig prompts verdeeld over de drie soorten, en volg ze in de modellen die je klanten gebruiken. Laat ze een paar weken lopen voordat je conclusies trekt. Open dan Brand Narrative, begin bij het tabblad Negative en kijk welk thema het vaakst terugkomt. Daar zit je eerste werk.
Brand Narrative zit op elk betaald plan van Promptwatch, ook op Essential (95 $/maand). Je kunt het 7 dagen gratis proberen bij maandelijkse betaling via de prijspagina van Promptwatch. Zet je belangrijkste koopvragen erin en lees na een week de eerste claims over je merk. Hoe je die claims daarna verbetert, staat in Merkperceptie in AI verbeteren: een stappenplan.