Merkperceptie in AI rapporteren: welke KPI's werken
Welke KPI's laten zien hoe AI je merk beschrijft, wat elk cijfer precies meet, wanneer het misleidt, en hoe je ze maandelijks rapporteert aan management.
Rapporteer merkperceptie in AI niet als één cijfer. Een enkele "AI-reputatiescore" op een managementslide voelt overzichtelijk, maar niemand kan erop sturen. Als hij daalt, weet je niet of AI je minder vaak noemt, later noemt, negatiever beschrijft of iets onjuists over je zegt. Dat zijn vier problemen met vier verschillende eigenaren.
Werkbaar is een klein setje KPI's die elk één vraag beantwoorden, met een vaste definitie die het hele team kent. Hieronder staan de KPI's die wij aanraden, wat ze precies meten volgens de definities van Promptwatch, wanneer ze je op het verkeerde been zetten, en hoe je er een maandrapport van maakt.
Eerst de vraag, dan het cijfer
Een marketingdirecteur wil over merkperceptie in AI meestal vier dingen weten. Worden we genoemd als klanten naar onze categorie vragen? Staan we dan vooraan of achteraan? Hoe positief klinkt het? En klopt wat er over ons gezegd wordt?
Elke KPI in je rapport hoort bij een van die vragen. De eerste gaat strikt genomen over zichtbaarheid, niet over perceptie, maar zonder dat cijfer is de rest niet te lezen. Een uitstekende toon in drie antwoorden per maand zegt weinig.
KPI 1: zichtbaarheid en share of voice per onderwerp
De Visibility Score loopt van 0 tot 100 en meet hoe prominent je in de antwoorden op je gevolgde prompts staat, op basis van plaatsing, aandeel van de aandacht en diepgang. Antwoorden waarin je ontbreekt, tellen als nul. Share of voice is je aandeel in alle merkvermeldingen binnen je filters, met maximaal één vermelding per antwoord per merk.
Rapporteer ze per onderwerp, niet als totaal. Sinds 26 oktober heeft Promptwatch daar een eigen Topics-pagina voor, onder Trends.
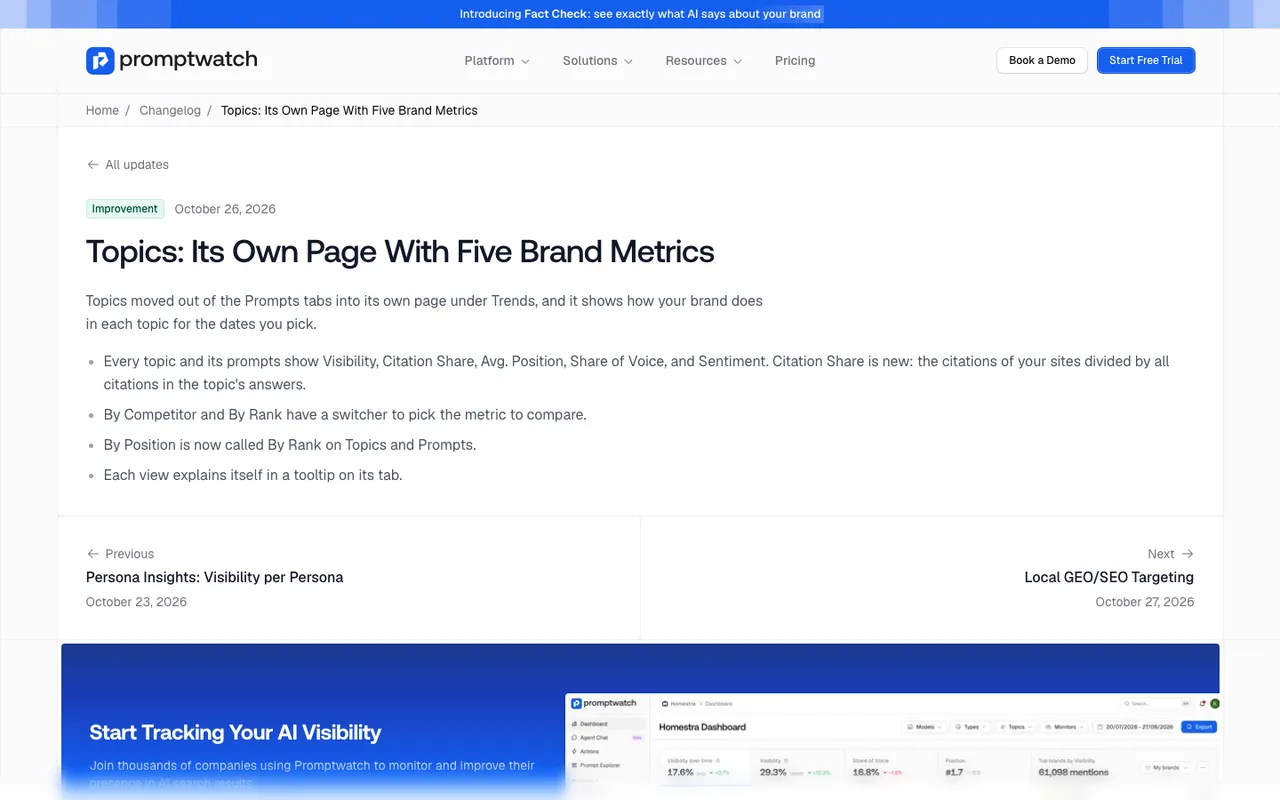 De changelogpagina over de Topics-pagina met vijf merkmetrics (26 oktober 2026), vastgelegd op 14 november 2026.
Elk onderwerp en de prompts daaronder tonen vijf metrics: Visibility, Citation Share, Avg. Position, Share of Voice en Sentiment. Citation Share is de nieuwste: de citaties van je eigen sites gedeeld door alle citaties in de antwoorden binnen dat onderwerp. In de weergaven By Competitor en By Rank kies je met een schakelaar welke metric je vergelijkt.
Voor een rapport is dat ideaal. Je zet per onderwerp vijf cijfers in een rij, en je ziet meteen waar het probleem zit. Hoge zichtbaarheid met laag sentiment op het onderwerp "prijzen" is een ander gesprek dan lage zichtbaarheid met prima sentiment op "integraties".
KPI 2: gemiddelde positie in het antwoord
Positie zegt waar je merk staat in de volgorde van merken binnen een antwoord, geteld vanaf 1. Noemt een antwoord eerst merk A, dan merk B en dan jou, dan is je positie 3. Lager is beter.
 De pagina Position in answer in de Promptwatch Academy, vastgelegd op 14 november 2026.
Voor perceptie is positie interessanter dan het lijkt. Het eerste merk in een antwoord is meestal het merk dat het model het sterkst met de vraag associeert. De Academy noemt dat categorie-associatie: brede berichtgeving die je merk aan de categorie koppelt, duwt je omhoog in de volgorde. Wie op positie 4 staat, wordt wel genoemd maar niet als de voor de hand liggende keuze gezien.
Lees een paar regels mee als je dit cijfer rapporteert. De eerste verschijning telt; latere herhalingen veranderen je positie niet. Een vermelding in een geciteerde URL of brontitel telt niet. Het gemiddelde wordt berekend over antwoorden die je noemen, dus een "#2,3" betekent gemiddeld net iets slechter dan als tweede merk genoemd. En splits op model voordat je conclusies trekt: volgens de Academy kom je op het ene platform vaak als eerste antwoord uit en op het andere als vijfde, en het gemengde gemiddelde laat geen van beide zien.
KPI 3: sentiment, met het volume erbij
De sentimentscore meet hoe positief AI je merk beschrijft, op een schaal van 100 punten, los van hoe zichtbaar je bent. Rond 50 is neutraal. Antwoorden waarin je alleen als kale naam in een rijtje staat, krijgen geen score.
Twee dingen maken dit cijfer bruikbaar in een rapport. Zet altijd het aantal gescoorde antwoorden ernaast, want op een dag met weinig vermeldingen kan één hard antwoord het daggemiddelde flink verschuiven. En rapporteer per prompttype. De Academy merkt op dat vergelijkingsprompts meestal lager scoren dan informatieve vragen. Ga je meer vergelijkingen volgen, dan daalt je gemiddelde zonder dat er iets aan je imago veranderd is.
KPI 4: themascores uit Brand Narrative
Sentiment zegt hoe het klinkt. Brand Narrative zegt waarover. Het haalt de letterlijke claims over jou en je concurrenten uit de antwoorden en verdeelt ze over negen thema's: Pricing, Features, Quality, Usability, Range, Support, Reputation, Audience en Company. Elk thema krijgt per merk een score van 0 tot 100, waarbij 50 neutraal is.
Voor een rapport is de benchmarkweergave het sterkst. Per thema zie je je rang tussen de concurrenten en het verschil met de beste. Een regel als "Support: rang 4 van 6, 12 punten achter de koploper" is concreet genoeg voor een gesprek met de supportmanager. Brand Narrative zit op elk plan.
Let op één beperking: claims die een prijs noemen, worden weggelaten. Het thema Pricing gaat dus over de perceptie van je prijs, zoals "duur" of "goede waarde", niet over de vraag of AI het juiste bedrag noemt.
KPI 5: nauwkeurigheid
Klopt wat AI over je zegt? Fact Check heeft daar een nauwkeurigheidsscore voor: het aandeel van de gecheckte vermeldingen van je merk dat juist is, van 0 tot 100. Elke keer dat AI een claim herhaalt, telt als vermelding, dus een foute claim die dagelijks terugkomt weegt zwaarder dan een eenmalige. Jouw markering gaat voor; claims zonder uitsluitsel en ongecheckte claims tellen niet mee. Een heatmap "Where does AI get it wrong?" laat de score per model en thema zien.
Fact Check zit op Business (579 $/maand), Agency Scale (799 $/maand) en Enterprise. Heb je een kleiner plan, laat deze KPI dan weg in plaats van hem met de hand te schatten.
Het overzicht
| KPI | Beantwoordt | Misleidt als | Plan |
|---|---|---|---|
| Zichtbaarheid en share of voice per onderwerp | Worden we genoemd? | Je merkprompts meetelt bij organische vragen | Elk plan |
| Gemiddelde positie | Staan we vooraan? | Je modellen door elkaar middelt | Elk plan |
| Sentiment | Hoe klinkt het? | Het volume ontbreekt of de promptmix verschuift | Elk plan |
| Themascores | Waarover zijn ze positief of negatief? | Je Pricing leest als prijsjuistheid | Elk plan |
| Nauwkeurigheid | Klopt het? | Je ongecheckte claims als juist beschouwt | Business, Agency Scale, Enterprise |
Van KPI's naar een rapport dat aankomt
Een goed rapport komt vanzelf, zonder dat iemand elke maand een export maakt. Promptwatch heeft daar een paar onderdelen voor.
Aangepaste dashboards bewaren je filters: datumbereik, modellen, prompttypes, onderwerpen en monitors. Zet je KPI's op één teamdashboard met organische prompts als standaardfilter, zodat iedereen dezelfde cijfers ziet. Elk merkplan bevat tien geplande PDF-rapporten. Een gepland rapport van een aangepast dashboard volgt de widgets en de naam van dat dashboard, ook als je ze later aanpast. Werk je met persona's, dan kan de personaradar als widget op het dashboard en in de PDF.
Rapporteert je organisatie in Looker Studio, dan heb je minstens Professional (245 $/maand) nodig. Daar beginnen de aangepaste rapporten en de Looker Studio-connector. Essential (95 $/maand) heeft geen van beide.
Een structuur die werkt voor een maandrapport van één pagina:
- Bovenaan zichtbaarheid en share of voice per onderwerp, met de verandering ten opzichte van vorige maand.
- Daaronder positie en sentiment, per model, met het aantal antwoorden erbij.
- Dan de benchmark per thema, met de twee thema's waar je het verst achterstaat.
- Als je Fact Check hebt: de nauwkeurigheidsscore en de drie meest herhaalde onjuiste claims.
- Onderaan wat er is gedaan en wat er volgende maand gebeurt, met een naam bij elke taak.
Dat laatste punt is wat een rapport onderscheidt van een overzicht. Zonder acties wordt het een maandelijks ritueel waarin iedereen knikt.
Wat je niet in een KPI moet stoppen
Rapporteer geen beloftes. Geen tool kan garanderen dat AI je volgende maand positiever beschrijft. Rapporteer wat je hebt aangepast en of de meting daarna beweegt. En trek geen conclusies uit één week: AI-antwoorden schommelen, en een trend zie je pas over meerdere weken.
Wil je zien hoe zo'n rapport eruitziet met je eigen merk en concurrenten, boek dan een demo van Promptwatch. Vraag in het gesprek specifiek naar de Topics-pagina en de benchmark in Brand Narrative, want daar komen de meeste KPI's uit dit artikel vandaan. Hoe je een wekelijks dashboard voor je team inricht, lees je in Een AI-zichtbaarheidsdashboard dat je team elke week opent.