Markdown in AI-zoekmachines: wat de data zegt
In één week citaties over ChatGPT, Claude, Perplexity en AI Overviews was HTML goed voor 99,94% en markdown voor 0,050%. Wanneer een .md-versie van je pagina's toch zin heeft.
Een markdownkopie van je site maken om vaker in AI-antwoorden te verschijnen: in de data van Promptwatch is daar geen enkele aanleiding voor te vinden. In een week citaties over vier AI-zoekmachines ging vrijwel alles naar gewone HTML-pagina's. Markdownbestanden waren een afrondingsfout.
Dat wil niet zeggen dat markdown nergens goed voor is. Het rapport zelf maakt onderscheid tussen AI-zoekmachines, die antwoorden met bronnen geven, en AI-agents, die documentatie ophalen om iets te bouwen. Voor die tweede groep kan een .md-versie wel zin hebben. Hieronder de cijfers, het onderscheid, en hoe je voor je eigen site nagaat wat er gebeurt.
Wat het rapport meet
Het rapport over markdown in AI-zoekmachines is gepubliceerd op 19 februari 2026. Het kijkt naar de laatste zeven dagen aan citaties over ChatGPT, Claude, Perplexity en Google AI Overviews, en deelt die in naar het formaat van de geciteerde bron. Een exacte datumreeks staat er niet bij. Vermoedelijk gaat het om de week voor publicatie, maar dat zegt de pagina niet letterlijk.
Het is dus één week, uit februari. Dat is een smalle basis, en het rapport is ook al negen maanden oud. Maar het verschil dat het laat zien, is zo groot dat een paar weken meer of minder er weinig aan zou veranderen.
De cijfers
HTML-pagina's waren goed voor 99,94% van de citaties. Markdownbestanden (.md) voor 0,050%, en afbeeldingen voor 0,015%. Het rapport noemt dat een verhouding van tweeduizend op één. Dat staat in het markdownrapport over de laatste zeven dagen voor 19 februari 2026.
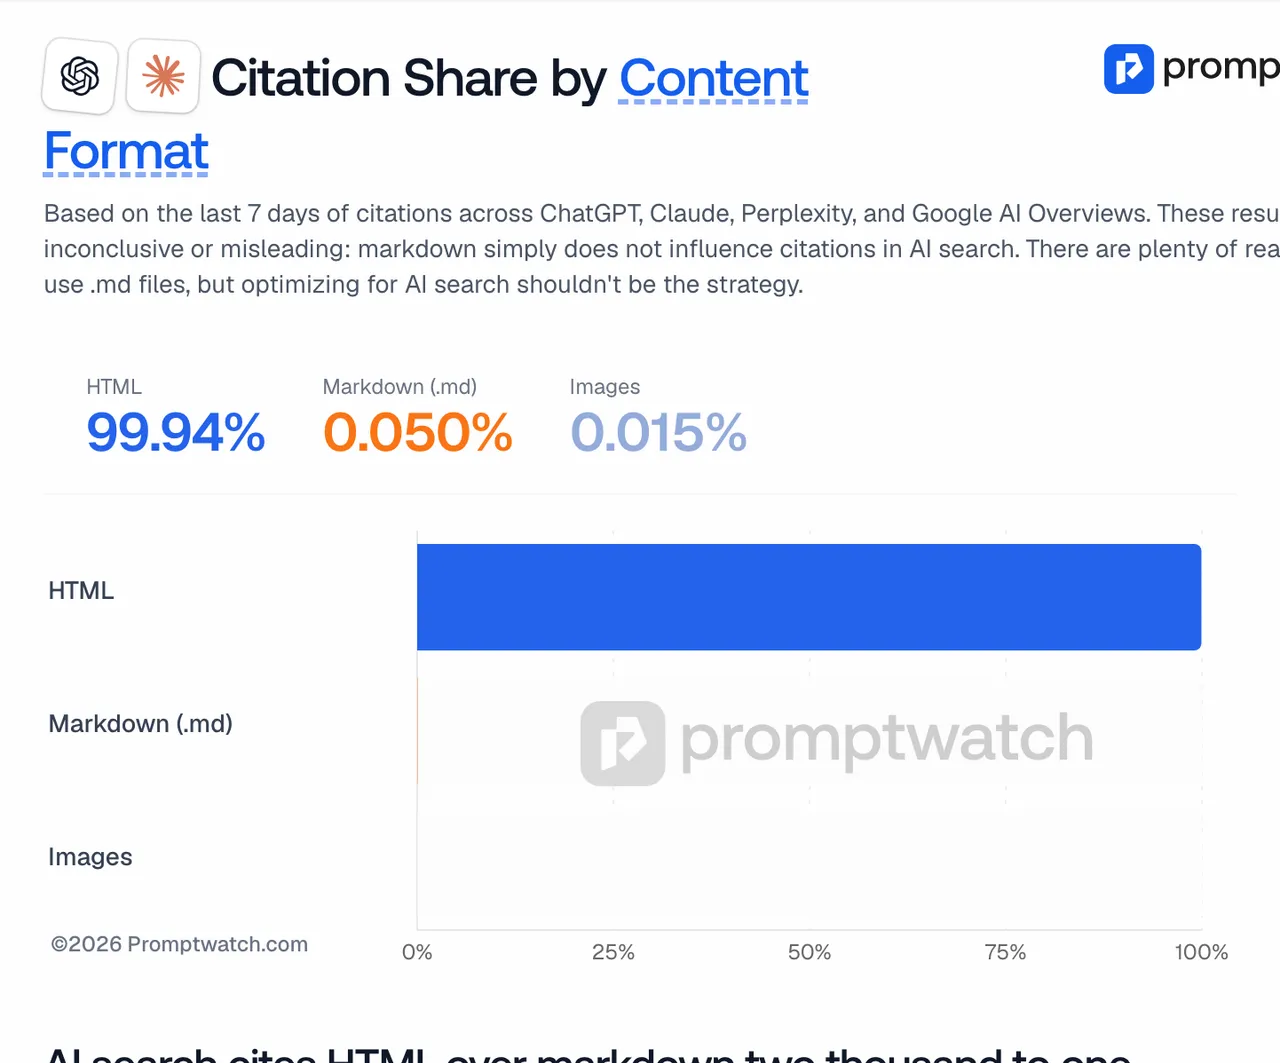 Promptwatch-grafiek "Citation Share by Content Format" (laatste zeven dagen voor publicatie op 19 februari 2026), vastgelegd op 14 november 2026.
In de grafiek is de balk van HTML vol, en die van markdown en afbeeldingen is niet eens te zien. De drie cijfers staan als kaarten boven de grafiek. Het rapport voegt er een stellige zin aan toe: de resultaten zijn volgens Promptwatch niet onduidelijk of misleidend, markdown heeft simpelweg geen invloed op citaties in AI-zoekmachines. Dat is de framing van de pagina zelf. Wij zouden voorzichtiger zeggen dat markdown in deze week geen rol van betekenis speelde als geciteerde bron.
Waarom het idee toch blijft hangen
De gedachte achter .md-kopieën is begrijpelijk. Markdown is schone tekst zonder navigatie, scripts en opmaak, dus een taalmodel zou het makkelijker kunnen lezen. Daar komt bij dat bestanden als llms.txt in markdown worden geschreven, waardoor markdown en "AI-vriendelijk" in veel gesprekken hetzelfde lijken te betekenen.
Maar makkelijk te lezen is niet hetzelfde als geciteerd worden. Een AI-zoekmachine geeft een bron die een mens kan aanklikken en controleren, en dat is in de praktijk een gewone webpagina. Onze lezing is dat dit de belangrijkste reden is voor de verhouding in het rapport. Het rapport zegt zelf niet waarom.
Over llms.txt specifiek schreven we eerder llms.txt: helpt het echt voor AI-zoekresultaten?. Dat stuk gaat over het bestand als routekaart. Dit stuk gaat over markdown als formaat van de pagina zelf.
Markdown is voor agents, niet voor zoekmachines
Het tweede deel van het rapport is interessanter dan het eerste. Volgens de pagina zag Promptwatch een flinke toename in documentatie die werd opgehaald door de bot van Claude, die Claude Code aandrijft, en door de bot van OpenAI, die Codex aandrijft. Een cijfer geeft het rapport daar niet bij, dus we kunnen de omvang niet noemen. Het rapport noemt ook Exa, een zoekmachine die op agents is gericht en is ingebouwd in tools als OpenCode.
Dat is een ander gebruik dan zoeken. Een coding agent die een integratie bouwt, wil de documentatie van een API lezen zonder menu's en cookiebanners eromheen. Daar kan een .md-versie van een documentatiepagina nuttig zijn. Het doel is dan dat de agent je product correct gebruikt, niet dat een antwoord in ChatGPT jouw pagina als bron noemt.
Wanneer een .md-versie wel zin heeft
Ons advies, op basis van dit onderscheid. Heb je een product waar ontwikkelaars mee bouwen, zoals een API, een SDK of een platform met integraties, dan kan het de moeite waard zijn om je documentatie ook als markdown beschikbaar te maken. Houd de HTML-pagina dan de hoofdversie, met dezelfde inhoud, zodat mensen en zoekmachines die blijven vinden. Laat de twee versies niet uit elkaar lopen.
Heb je geen ontwikkelaars als doelgroep, dan levert een markdownkopie van je marketingpagina's volgens deze data niets op. Het kost onderhoud en voegt een tweede versie toe die verouderd kan raken.
Het rapport geeft zelf aan waar de moeite beter naartoe kan: naar de HTML. Een logische kopstructuur, semantische opmaak en inhoud die de server direct meestuurt in plaats van pas na het laden van JavaScript. Dat zijn dingen waar elke pagina van profiteert, voor mensen en voor bots.
Een voorbeeld
Neem een betaalplatform dat we Acme Pay noemen, met een marketingsite en een ontwikkelaarsportaal. Het marketingteam overweegt om van alle pagina's een .md-versie te maken, omdat het ergens heeft gelezen dat AI dat prettiger leest.
Op basis van dit rapport zou je dat voor de marketingsite niet doen. De pagina's die Acme Pay in ChatGPT of AI Overviews geciteerd wil zien, zijn de gewone HTML-pagina's over tarieven, koppelingen en veiligheid. Daar gaat de tijd naar betere koppen, een helder antwoord bovenaan en inhoud die zonder JavaScript leesbaar is.
Voor het ontwikkelaarsportaal ligt het anders. Daar lezen coding agents mee wanneer iemand een betaling wil inbouwen. Een markdownversie van de API-referentie, met dezelfde inhoud als de HTML, kan die agents helpen. Of dat ook gebeurt, zie je in de logs: halen bots die .md-bestanden op, en welke?
Afbeeldingen: nog kleiner
Afbeeldingen kwamen in dezelfde week op 0,015% van de citaties, volgens het markdownrapport over de laatste zeven dagen voor 19 februari 2026. Een afbeelding als losse bron wordt dus nog minder geciteerd dan een markdownbestand. Dat zegt niets over de waarde van afbeeldingen op een pagina voor lezers. Het zegt wel dat een infographic zonder begeleidende tekst weinig kans heeft om zelf als bron te verschijnen. Zet de kern van wat de afbeelding laat zien ook in de tekst eromheen.
Zo controleer je wat er op je eigen site gebeurt
Het rapport is een gemiddelde. Of bots op jouw site .md-bestanden ophalen, en welke, zie je alleen in je eigen logs. Agent Analytics in Promptwatch toont IP-geverifieerde AI-crawler logs. Met een filter op het pad kun je bijvoorbeeld alleen verzoeken naar bestanden die op .md eindigen bekijken, en zien welke bots dat zijn. Crawler logs zitten in de abonnementen voor merken vanaf Professional (245 $/maand).
Sinds 6 november volgt Promptwatch ook de twee crawlers van Exa: ExaSearchBot, die de index van Exa opbouwt, en ExaUser, die een pagina live ophaalt wanneer een persoon of een app via Exa iets vraagt. Exa publiceert geen IP-reeksen, dus die twee krijgen geen verificatiebadge. Omdat OpenCode via Exa zoekt, is dat voor ontwikkelaarsproducten een relevante plek om te kijken.
Wil je weten wat coding agents over je product zeggen, dan volgt Promptwatch daarnaast welke tools, libraries en documentatie Codex, Claude Code en OpenCode aanraden. Dat is de meting die bij de agentkant van dit verhaal hoort.
 De pagina met gratis tools van Promptwatch, vastgelegd op 14 november 2026.
Voor een eerste controle zonder account staan er op de pagina met gratis tools een paar die hierbij passen: de AI Page Token Inspector en de AI Crawler URL Inspector voor afzonderlijke pagina's, en voor wie toch een llms.txt wil de llms.txt-generator. Gebruik ze om je HTML te controleren voordat je aan een tweede formaat begint.
Begin bij je HTML
Voordat je een .md-kopie bouwt: draai het gratis AI Visibility Report op je domein. Het scant ChatGPT, Gemini en Perplexity, kijkt of AI-crawlers toegang hebben en geeft een zichtbaarheidsscore. Blijkt je HTML niet goed bereikbaar, dan weet je waar je eerste uur naartoe moet. Een markdownbestand lost dat niet op.